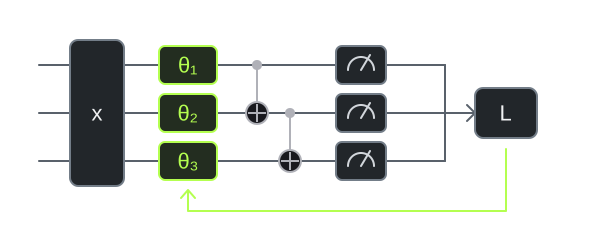
重复执行前向计算、损失评估、梯度计算和参数更新。
MODULE / 02 · QUANTUM MACHINE LEARNING
ArcQML
量子机器学习框架
连接参数化量子线路、状态模拟、自动微分与经典优化器,为量子神经网络的构建、训练和验证提供统一执行流程。
ArcQML量子与经典训练闭环
- 核心能力
- Automatic Differentiation
- 实验负载
- Quantum Neural Network
- 对比维度
- Training / Validation
FRAMEWORK / 01
连接量子线路
与经典训练流程
框架以统一接口组织数据编码、参数化量子线路、梯度计算和参数更新,并为不同量子机器学习后端保留一致的实验入口。
- 01数据与参数输入
准备训练样本、线路结构与可训练参数。
- 02参数化线路执行
在目标模拟后端完成量子态演化与测量。
- 03梯度计算
连接损失函数与自动微分流程,生成参数梯度。
- 04经典参数更新
由优化器迭代参数并进入下一轮训练。
WORKFLOW / 02
训练与验证
共享统一执行后端
训练阶段关注完整迭代开销,验证阶段关注固定参数下的执行效率。两组结果共同反映框架在不同线路深度与线程配置下的表现。
使用训练后的参数执行模型,比较不同框架的验证总时间。
分别固定电路层数或线程数,观察并行扩展与线路规模带来的影响。
Ubuntu 24.04.4 LTS · Intel Xeon Platinum 8253 · ArcQML 0.1.0
测试环境与任务配置 适用于本页全部 QNN、VQE 性能图表(含总览)
以下为各组测试共用的软件与设备环境。整机核心数表示设备容量;QNN 测试线程数以对应图表为准。
| 项目 | 参数 |
|---|---|
| CPU | Intel Xeon Platinum 8253 @ 2.20 GHz |
| 整机物理核心 | 8 插槽 × 16 核,共 128 核 |
| CPU 拓扑 | 256 个逻辑 CPU,8 个 NUMA 节点 |
| 系统内存 | 约 2.95 TiB |
| 操作系统 | Ubuntu 24.04.4 LTS |
| Linux 内核 | 6.8.0-117-generic |
| 运行平台 | x86_64;glibc 2.39 |
| 软件 | 实验使用版本 |
|---|---|
| Python | 3.11.15 |
| ArcQML | 0.1.0 |
| MindQuantum | 0.12.0 |
| PennyLane | 0.45.1 |
| PennyLane Lightning | 0.45.0 |
| TensorCircuit | 0.12.0 |
| JAX | 0.4.38 |
| TensorFlow | 2.18.1 |
| TensorFlow Quantum | 0.7.6 |
| Cirq-core | 1.5.0 |
| 电路层数 | 参数数量 | 总门数量 |
|---|---|---|
| 1 | 37 | 72 |
| 10 | 370 | 540 |
| 20 | 740 | 1060 |
| 30 | 1110 | 1580 |
| 40 | 1480 | 2100 |
| 分子 | 量子比特数 | 哈密顿量项数 |
|---|---|---|
| H2 | 4 | 15 |
| LiH | 6 | 62 |
| BeH2 | 8 | 61 |
| HF | 10 | 276 |
| H2O | 12 | 551 |
| NH3 | 14 | 1750 |
VQE 测试电路层数:6、17、34、67、134 层。以下电路数据来自 ArcQML VQE 的 30 份原始测试记录。每格为“参数数量 / 总门数量”;窄屏下可左右滚动查看全部层数。
| 分子体系 | 6 层 | 17 层 | 34 层 | 67 层 | 134 层 |
|---|---|---|---|---|---|
| H2 | 48 / 74 | 136 / 206 | 272 / 410 | 536 / 806 | 1072 / 1610 |
| LiH | 72 / 110 | 204 / 308 | 408 / 614 | 804 / 1208 | 1608 / 2414 |
| BeH2 | 96 / 148 | 272 / 412 | 544 / 820 | 1072 / 1612 | 2144 / 3220 |
| HF | 120 / 188 | 340 / 518 | 680 / 1028 | 1340 / 2018 | 2680 / 4028 |
| H2O | 144 / 224 | 408 / 620 | 816 / 1232 | 1608 / 2420 | 3216 / 4832 |
| NH3 | 168 / 260 | 476 / 722 | 952 / 1436 | 1876 / 2822 | 3752 / 5636 |
ArcQML VQE 运行设置
CPU 单线程;每次运行 100 个训练步,重复 3 次,耗时取中位数;单步时间为运行耗时中位数除以 100。优化器为 Adam,学习率为 0.05;数值精度为 float64 / complex128,基组为 STO-3G,映射方式为 Jordan–Wigner。以上运行设置仅依据 ArcQML VQE 原始记录标注。
RESULTS / 03 · QNN OVERVIEW
QNN 综合
性能总览
以 ArcQML 的运行时间为基准(1),对比不同框架完成相同 QNN 任务的相对耗时。柱状图采用对数刻度,数值越小,代表运行时间越短。
RESULTS / 04 · QNN BENCHMARK
QNN 训练与验证
性能结果
固定电路层数,横轴改变线程数量,观察不同框架的并行扩展表现。
01 / 05
RESULTS / 05 · VQE OVERVIEW
VQE 综合
性能总览
以 ArcQML 的时间和峰值内存为基准(均为 1),对比不同框架执行 VQE 的综合开销。横轴为相对时间,纵轴为相对峰值内存;越靠近左下方,时间与内存开销越低。
RESULTS / 06 · VQE DETAILS
VQE 时间与内存
详细结果
固定 VQE 电路层数,横轴改变量子比特数量,对比不同框架的时间与峰值内存开销。
01 / 05